AI에게 버그 수정을 맡기면, 코드만 한 번 읽고 끝나는 게 아닙니다. 관련 파일을 살피고, 테스트를 실행하고, 실패한 로그를 읽으며 수정을 반복합니다. 그 과정에서 모델이 처리해야 할 문맥도 계속 늘어납니다.
첫 요청에 코드 10,000토큰이 들어갔다면 다음 요청에는 그 코드에 실행 로그와 도구 호출 결과가 더해집니다. 이미 읽은 부분은 캐시로 재사용할 수 있지만, 새 입력을 처리하고 이전 문맥을 보관하는 비용까지 사라지지는 않습니다. 답변을 빨리 생성하는 모델이어도, 답변을 시작하기 전에 긴 입력을 읽느라 기다리게 할 수 있습니다.
DeepSeek V4.1 Flash를 볼 때 흥미로운 부분이 여기입니다. 이 모델은 긴 입력을 어디까지 계산할지, 계산한 문맥을 얼마나 저장할지, 저장한 문맥 중 무엇을 읽을지를 함께 바꿨습니다. 여기에 짧은 토큰 패턴을 별도 메모리에서 조회하는 Engram을 더했습니다. 공식 모델 카드
이 글에서는 먼저 Engram의 n-gram 조회를 살펴봅니다. 같은 접근을 채택한 Qwen3.8-Flash-Next를 함께 보면, 학습된 지식을 저장하는 일과 지금 읽는 문맥을 기억하는 일이 어떻게 다른지 드러납니다. 그다음 CED와 CSA2가 긴 입력의 계산·저장 비용을 줄이는 과정을 따라가겠습니다.
2026년 9월 15일 기준 공식 기술 보고서와 공개 코드를 분석했습니다. 성능 관련 서술은 각 연구팀의 보고이며, 메모리 계산은 공개 설정에 근거한 값입니다. 직접 실행한 벤치마크는 아닙니다.
모델이 답하기 전에 하는 일
LLM의 추론은 크게 두 단계입니다. 먼저 입력을 한꺼번에 처리하는 prefill, 그다음 답변을 한 토큰씩 만드는 decode입니다. 테스트 로그를 읽고 다음 수정안을 생성할 때도 이 두 단계를 거칩니다.
입력을 처리하면서 모델은 토큰의 정보를 Key와 Value라는 벡터로 만듭니다. 이후 attention이 앞의 문맥을 참고할 때 다시 쓰도록 이 벡터를 저장한 것이 KV cache입니다. 원문을 그대로 보관하는 저장소라기보다, 모델이 원문을 읽고 만든 중간 계산 결과에 가깝습니다.
문맥이 길어지면 이 상태도 커집니다. 여러 작업을 동시에 처리하면 각 요청의 상태를 보관해야 합니다. 필요한 문맥을 찾기 위해 읽는 데이터의 양도 문제가 됩니다. V4.1 Flash는 입력 처리, 상태 보관, 문맥 검색의 비용을 분리해서 줄입니다.
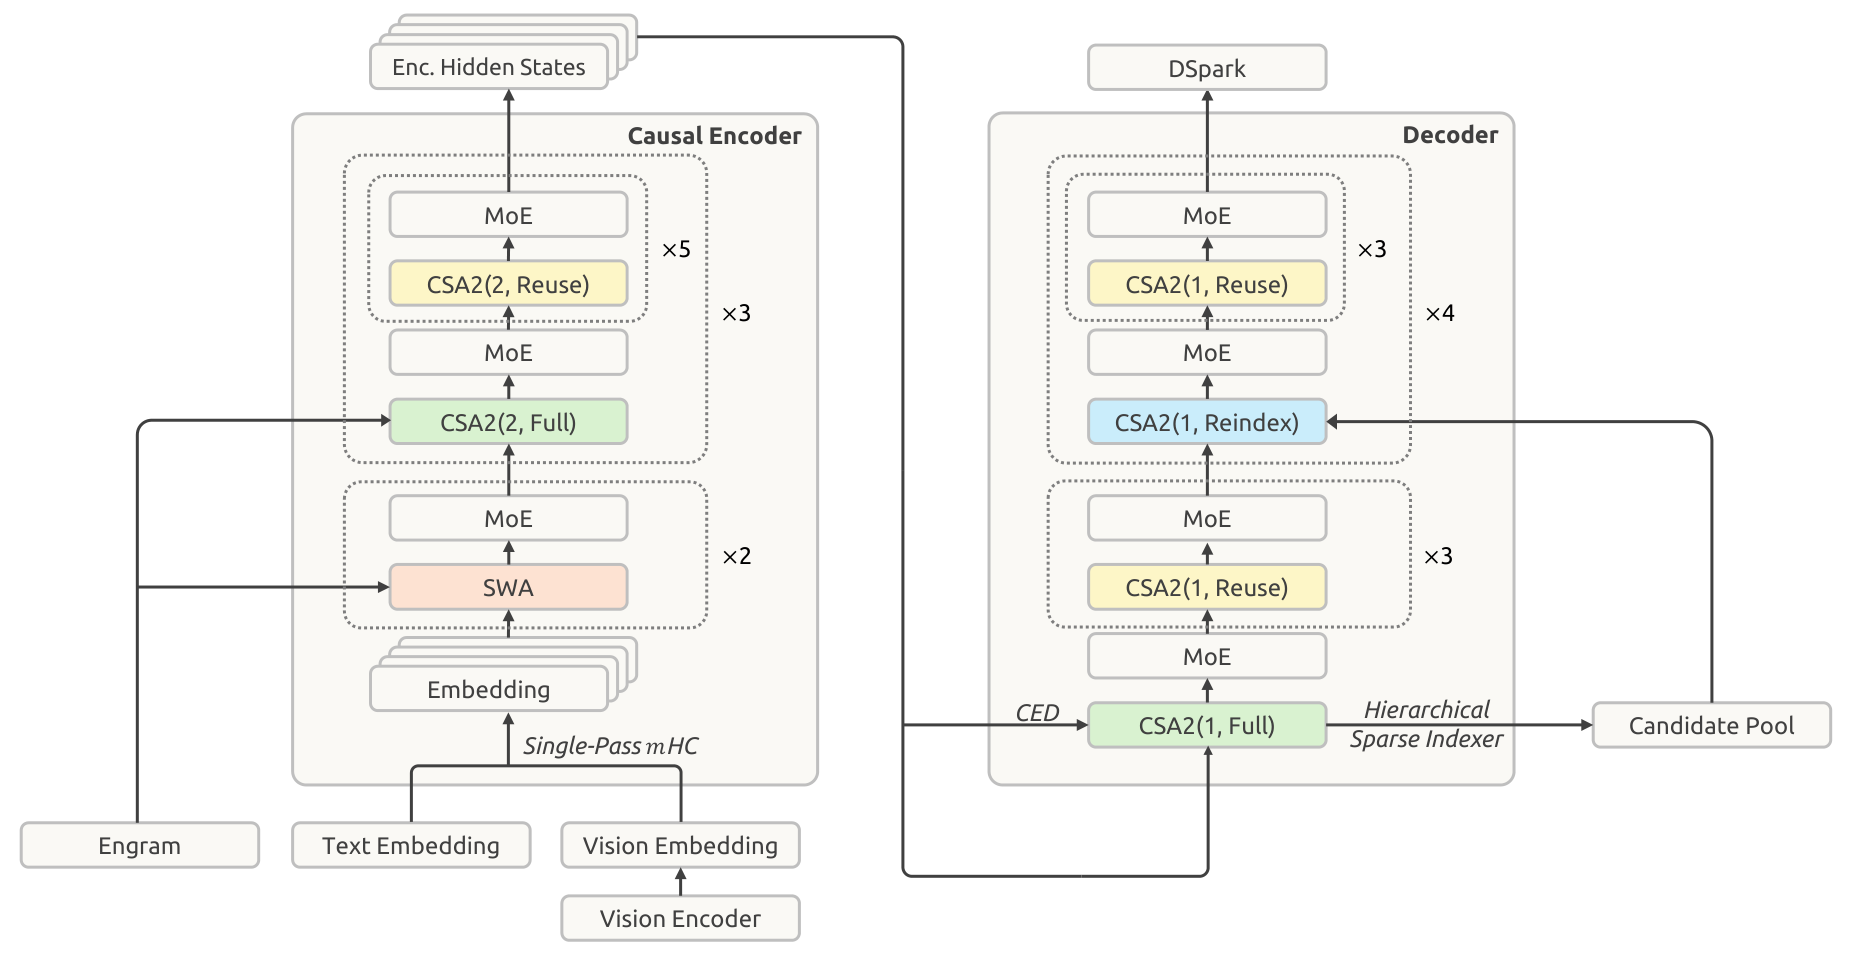
그 기반은 40개 Transformer 층입니다. 앞의 20개를 causal encoder, 뒤의 20개를 decoder로 나눴습니다. Encoder라고 해서 뒤의 토큰까지 미리 보는 구조는 아닙니다. 두 구간 모두 현재 토큰과 그 앞의 정보만 사용하는 causal 모델입니다.
각 층에는 MoE도 들어갑니다. 공유 expert 1개에 더해, routed expert 384개 중 토큰마다 6개를 사용합니다. MoE가 계산에 참여할 파라미터를 고른다면, 뒤에서 설명할 sparse attention은 참고할 문맥의 위치를 고릅니다. 서로 다른 선택입니다.
Backbone은 552B이고 Engram 파라미터 196B가 별도로 있습니다. 공식 자료의 prefill 8B / decode 16B는 토큰당 활성 파라미터입니다. 가중치 전체가 8B라는 의미는 아닙니다. 입력과 출력에서 활성 규모가 달라지는 이유는 뒤의 CED 절에서 살펴보겠습니다. 기술 보고서 §2.1, §4.2.1
Engram: 짧은 패턴은 매번 계산하지 않고 찾아 쓴다
앞서 설명한 KV cache는 현재 요청을 처리하며 만든 상태입니다. Engram은 성격이 다릅니다. 학습 과정에서 만들어진 거대한 embedding table, 즉 모델 파라미터입니다.
언어와 코드에는 짧은 조합이 반복됩니다. Engram은 이런 조합의 표현을 매번 Transformer 연산만으로 만들어 내는 대신, 학습된 표에서 조회해 보탭니다. 특정 문자열에 대응하는 정답 문장을 저장한 사전은 아닙니다. 조회 결과는 이후 계산에 사용할 숫자 벡터입니다.
한 토큰 대신 짧은 조합으로 조회한다
일반적인 token embedding은 같은 token ID에 같은 초기 벡터를 줍니다. 앞뒤 문맥에 따른 의미는 이후 층에서 만들어집니다. n-gram embedding은 조회할 때부터 직전 토큰을 함께 봅니다. 같은 마지막 토큰이어도 앞에 무엇이 왔는지에 따라 다른 주소를 읽을 수 있습니다.
예전의 n-gram 언어 모델처럼 등장 횟수를 세어 다음 단어의 확률을 직접 구하는 방법은 아닙니다. 여기서는 토큰 조합으로 학습된 벡터를 찾고, 그 벡터를 신경망의 계산에 보태는 것이 핵심입니다. MoE나 attention을 없애는 것이 아니라 짧고 반복적인 패턴을 표현할 경로를 하나 더 둡니다.
n-gram을 실제로 어떻게 쓰는가
n-gram은 연속된 토큰 n개의 묶음입니다. 현재까지의 token ID가 [a, b, c, d]라면, 현재 위치 d에서 끝나는 묶음은 다음과 같습니다. 알파벳은 설명용 ID이며 실제 단어나 문자 하나를 뜻하지 않습니다.
2-gram:       [c, d]
3-gram:    [b, c, d]
4-gram: [a, b, c, d]
V4.1 Flash는 이 세 종류를 사용합니다. 각 묶음을 여러 hash 함수에 넣어 table의 주소를 얻고 그 주소의 embedding을 읽습니다. 차수마다 8개 hash head를 사용하므로 한 해시 충돌이 표현 전체를 결정하지 않게 구성합니다. 조회 결과들을 이어 붙인 뒤 key와 value로 변환합니다. 기술 보고서 §2.4.2 · engram.py
조회 전에 비슷한 token을 같은 조회용 ID로 합치는 과정도 있습니다. 공개 코드의 tokenizer compression은 대소문자, 공백, Unicode 표현 등을 정규화합니다. 입력 문장의 토큰 수를 줄이는 것이 아니라 Engram이 사용하는 ID 공간을 정리하는 과정입니다.
같은 패턴이어도 문맥에 따라 다르게 반영한다
짧은 토큰 묶음만으로 의미가 결정되지는 않습니다. 그래서 조회한 값을 그대로 넣는 대신, 현재 hidden state와 조회 결과의 key를 비교해 gate를 계산합니다. Hidden state는 앞선 계산을 통해 문맥이 반영된 표현이고, gate는 가져온 value를 얼마나 반영할지 정하는 값입니다.

개념적으로는 기존 표현 + gate × 조회한 value입니다. 같은 n-gram이 나와도 문맥이 다르면 gate가 달라질 수 있습니다. 실제 구현은 정규화된 내적, 부호를 유지하는 제곱근, sigmoid를 거쳐 gate를 계산합니다. Attention은 계속 긴 문맥을 처리하므로, 모델이 최근 네 토큰만 보게 되는 것도 아닙니다.
V4.1의 Engram은 기존 설계에 있던 짧은 causal convolution을 생략했습니다. 보고서는 얻는 성능 이득에 비해 추론 구현의 복잡성이 커졌기 때문이라고 설명합니다. 위 원본 그림의 Conv가 V4.1에도 있다고 읽으면 안 되는 이유입니다. 기술 보고서 §2.4.2 · Engram.forward
196B를 더하면서 계산량을 크게 늘리지 않는 이유
Engram은 layer 1과 14, 두 곳에 들어갑니다. 각 hash head에서 256차원 embedding을 읽고, 차수당 8개 head와 세 차수를 합쳐 6,144차원의 조회 결과를 만듭니다. 두 module의 embedding table 전체를 합치면 약 196.1B 파라미터입니다.
Table은 크지만 토큰 하나를 처리할 때 전체를 곱하지는 않습니다. 필요한 row만 읽습니다. 더구나 주소가 앞선 층의 계산 결과가 아니라 입력 token ID로 정해지므로 어떤 row가 필요할지 미리 알 수 있습니다. 보고서는 host memory에서 필요한 embedding을 RDMA로 미리 가져오고, 그 전송을 다른 계산과 겹치는 방식을 설명합니다.
늘어난 파라미터를 적은 조회 연산으로 활용하는 대신 큰 메모리와 전송 경로가 필요합니다. FP8로 저장해도 table 원소만 약 196GB입니다. Engram을 ‘거의 공짜로 지식을 추가하는 장치’라고 보기보다, 연산과 메모리 대역폭 사이의 다른 선택으로 보는 편이 정확합니다. 기술 보고서 §2.4.2, §3.1.3 · 공개 설정
이름이 비슷한 방법들과도 구분해야 합니다. KV cache는 이번 입력의 계산 결과를 재사용하고, Engram은 학습된 파라미터를 조회합니다. RAG는 외부 문서를 찾아 입력에 추가합니다. n-gram speculative decoding은 반복되는 토큰 구간에서 다음 출력 후보를 제안합니다. Engram은 사내 문서를 최신 상태로 검색하거나 사용자의 대화를 영구 기억하는 기능이 아닙니다.
Qwen은 n-gram을 어떻게 쓸까?
이 접근을 DeepSeek만의 특수한 장치로 볼 필요는 없습니다. Qwen3.8-Flash-Next도 학습된 n-gram embedding을 별도로 둡니다. 공식 모델 카드의 규모는 125B 모델에 토큰당 6B 활성, 별도 n-gram embedding 51B입니다. 큰 표를 전부 계산하는 것이 아니라 필요한 일부를 조회한다는 점에서 Engram과 방향이 같습니다. Qwen 공식 모델 카드
| n-gram 구성 | DeepSeek V4.1 Flash | Qwen3.8-Flash-Next |
|---|---|---|
| 조회에 쓰는 토큰 묶음 | 2·3·4-gram | 2·3-gram |
| 별도 embedding 규모 | 약 196B | 약 51B |
| 넣는 위치 | 두 곳: layer 1, 14 (0부터 셈) | 얕은 층 한 곳 |
Qwen도 multi-head hashing으로 조회하고, 문맥을 반영한 gate를 거쳐 결과를 더합니다. 얕은 층에 넣으면 앞선 층이 계산하는 동안 host memory에서 필요한 row를 미리 가져올 수 있습니다. 두 모델에서 공통으로 중요한 점은 조회 주소를 미리 알 수 있어서 메모리 전송과 계산을 겹칠 수 있다는 것입니다. Qwen 기술 보고서 §2.3
그렇다고 표를 키우는 만큼 추론 능력이 좋아지는 것은 아닙니다. Qwen의 요소별 비교 실험에서는 표가 커질수록 loss(학습 오차)는 낮아져도 개별 과제의 평가 점수는 정체되거나 오르내렸습니다. MoE의 expert 수를 줄여 n-gram에 같은 파라미터 예산을 배분한 실험도 일관된 개선을 보이지 않았습니다. 학습된 패턴을 더 많이 저장하는 능력과 복잡한 문제를 푸는 능력을 같은 것으로 볼 수 없다는 결과입니다. Qwen 기술 보고서 §2.3.2
또 하나의 차이는 token 정규화입니다. DeepSeek는 조회용 ID를 합치는 tokenizer compression을 사용하지만, Qwen은 이 방법을 실험해도 자기 학습 구성에서 일관된 이득을 얻지 못했다고 보고합니다. n-gram을 쓴다는 이유만으로 같은 구현이나 같은 효과를 가정하면 안 됩니다. Qwen 기술 보고서 §2.3.2
GDN은 과거 토큰 대신 무엇을 남길까?
Qwen의 또 다른 특징은 Gated DeltaNet, GDN과 Qwen Sparse Attention, QSA를 섞은 구조입니다. 48층을 GDN 3층 + QSA 1층씩 반복합니다. 각 층에는 MoE도 있습니다. 이는 attention을 유지하면서 KV를 압축·공유하는 DeepSeek V4.1과 다른 선택입니다. Qwen 모델 구성
일반적인 full attention은 과거 토큰의 key와 value를 위치별로 보관하고, 현재 query와 비교해 필요한 정보를 읽습니다. 문맥이 길어지면 저장할 KV도 늘어납니다. 반면 GDN은 정해진 크기의 행렬 하나에 과거 정보를 누적해 갱신합니다. 정확히는 층의 각 head가 자기 상태를 가집니다. 문장이 길어져도 이 행렬의 크기는 늘어나지 않습니다. Qwen 기술 보고서 §2.1.1
이 상태를 S라고 하겠습니다. 현재 토큰에서 만든 key k는 어떤 연결을 갱신할지, value v는 그 연결에 반영할 정보를 나타냅니다. 이후에는 query q로 상태를 읽습니다. 단어마다 주소가 하나씩 있는 사전이 아니라, 여러 연결이 겹쳐 담긴 수치 행렬입니다. 토큰을 따로 보관하지 않는 대신, 무엇을 남기고 어떻게 고칠지가 중요해집니다.
Gated는 얼마나 남길지, Delta는 얼마나 고칠지
GDN은 두 동작을 결합합니다. Mamba2와 연결되는 부분은 decay gate α입니다. 기존 상태를 얼마나 남길지 조절합니다. write gate β는 현재 key에서 읽은 값과 새 value 사이의 차이를 얼마나 반영할지 조절합니다. 둘 다 입력에 따라 모델이 계산하는 값이지, 사용자가 정하는 기억 설정이 아닙니다. Gated Delta Networks 논문 §2–3
핵심 갱신식만 풀어 쓰면 다음과 같습니다. kᵀ는 key를 가로로 놓은 벡터이고, 마지막 곱은 보정값을 상태 행렬에 기록하는 outer product입니다.
남길 상태   M = α × S
기존 값     old = M × k
차이        delta = v - old
갱신        S_new = M + β × delta × kᵀ
새 정보 전체를 무조건 더하는 것이 아니라 현재 상태가 이미 담고 있는 값과의 차이를 더합니다. 갱신한 상태에서는 S_new × q로 정보를 읽습니다. 위 식은 GDN 논문의 표기 방향을 따른 것으로, Qwen 구현의 상태 행렬은 전치된 방향을 사용하지만 같은 갱신을 계산합니다. GDN 식 (10) · Qwen 식 (1)–(4)
계산만 보기 위해 상태와 value를 숫자 하나로 줄여 보겠습니다. k = 1, α = 1로 두고, 기존 값이 30인데 새 값이 60이라면 차이는 30입니다. β = 0.5일 때는 30 + 0.5 × (60 - 30) = 45가 됩니다. 새 값 60을 그대로 더해 90을 만드는 것과 다릅니다. 실제 모델이 설정값이나 초 단위를 이런 숫자 하나로 저장한다는 뜻은 아닙니다. 보정 원리를 보여주기 위한 예시입니다.
Mamba2식 decay만으로는 한 연결을 고치려고 다른 기억도 함께 약하게 만들 수 있습니다. Delta update는 현재 key 방향을 겨냥해 수정합니다. 다만 비슷한 key끼리는 간섭할 수 있어, 다른 정보가 전혀 영향을 받지 않는 것은 아닙니다. 반대로 문맥이 크게 바뀔 때는 decay가 낡은 상태를 빠르게 비우는 데 유용합니다. GDN은 이 두 조절을 함께 사용합니다. 여기서 갱신하는 것은 현재 문맥의 상태이며, 모델 전체 가중치를 다시 학습하는 것이 아닙니다. Gated Delta Networks 논문 §3
그래도 Attention을 함께 쓰는 이유
고정 크기의 상태는 저장 비용을 줄이지만, 긴 입력의 모든 세부 사항을 그대로 보존하지는 못합니다. 긴 로그의 특정 한 줄이나 오래전에 나온 식별자를 정확히 다시 찾아야 할 때는, 과거 토큰의 표현을 직접 참고하는 경로가 도움이 됩니다. GDN의 장점은 무제한 기억이 아니라, 문맥을 이어 가는 비용을 제한하는 데 있습니다. Qwen 기술 보고서 §2.1.1
그래서 Qwen은 GDN만 사용하지 않고 QSA를 주기적으로 넣습니다. 상태에 요약해서 이어 갈 경로와 과거 위치를 직접 참고할 경로를 함께 남깁니다. 고정 크기인 것은 GDN의 recurrent state이지, QSA의 KV까지 포함한 모델 전체 캐시가 아닙니다. GDN은 Mamba2와 연결되는 연구이지만 Qwen을 단순히 ‘Mamba 모델’이라고 부르면 이 혼합 구성이 가려집니다. Qwen 기술 보고서 §2.1.1 · Gated Delta Networks
여기서 두 종류의 기억을 나누면 됩니다. n-gram table은 학습해 둔 패턴을 가져오는 곳, GDN state와 attention KV는 지금 읽고 있는 문맥을 담는 곳입니다. 서로 대체재가 아니므로 같은 모델에 함께 들어갈 수 있습니다.
DeepSeek V4.1에서도 Engram만으로 긴 코드나 로그를 읽는 비용이 없어지지는 않습니다. 그 문제를 따로 해결하는 것이 이제 살펴볼 CED와 CSA2입니다.
긴 입력을 40층 끝까지 보내지 않는 CED
Engram이 학습된 패턴의 조회를 맡는다면, CED는 현재 요청의 긴 입력을 처리하는 비용을 줄입니다. 일반적인 decoder-only Transformer에서는 입력을 모든 층에 통과시켜야 합니다. 각 층이 자신에게 들어온 표현으로 KV를 만들기 때문입니다. 30번째 층에서 과거 코드를 참고하려면, 그 코드를 30번째 층까지 계산해 둔 상태가 필요합니다.
V4.1 Flash의 Causal Encoder–Decoder, CED는 이 연결을 바꿉니다. 뒤쪽 decoder가 긴 문맥을 읽는 데 사용할 KV를, 각 decoder 층이 아니라 마지막 encoder 층의 출력에서 준비합니다.
긴 소스코드를 앞의 20층에서 읽은 결과로 뒤의 20층이 참고할 문맥을 만드는 셈입니다. Decoder용 문맥을 준비하기 위해 모든 입력 토큰을 decoder 끝까지 보낼 필요가 없어집니다. 기술 보고서 §2.2
일반적인 Transformer
입력 → 1층 → 2층 → … → 마지막 층
       각 층에서 그 층의 KV 생성

CED의 긴 문맥 경로
입력 → encoder 20층 → decoder용 global KV 준비
다만 최근 토큰은 한 번 더 처리한다
이 모델의 attention에는 두 경로가 있습니다. Global attention은 멀리 있는 문맥을 찾고, Sliding Window Attention, SWA는 최근 128토큰을 촘촘히 읽습니다. 긴 코드 안에서 멀리 떨어진 함수를 찾는 일과, 지금 이어 쓰는 코드 주변을 살피는 일을 나눴다고 생각하면 이해하기 쉽습니다. 실제로 어느 정보가 어느 경로에 실리는지는 학습 결과에 따라 달라집니다.
CED가 미리 준비하는 것은 global KV입니다. SWA의 KV는 decoder의 각 층에서 직접 만들어야 합니다. 그래서 입력의 마지막 128토큰은 decoder 20층에도 통과시켜, 답변을 시작할 때 필요한 최근 문맥의 상태를 준비합니다. 보고서에서는 이를 bounded replay라고 부릅니다.
앞의 10,000토큰 예시로 차이를 계산해 보겠습니다. 단순히 ‘토큰 하나가 층 하나를 통과하는 횟수’를 세면, 모든 층을 사용하는 경로는 10,000 × 40 = 400,000입니다. CED는 10,000 × 20 + 128 × 20 = 202,560입니다. 긴 입력일수록 마지막 128토큰의 추가 비용이 차지하는 비중이 작아집니다.
이 계산은 왜 prefill의 작업량을 크게 줄일 수 있는지 보여줍니다. 정확한 FLOPs나 응답 시간의 공식은 아닙니다. Attention 내부 연산, GPU 간 통신, 여러 요청을 묶는 방식에 따라 실제 시간은 달라집니다. 입력 경로는 줄이지만, 새 답변 토큰을 만들 때는 encoder와 decoder를 모두 사용합니다. 앞서 본 활성 규모 차이도 여기서 나옵니다.
남는 대가는 있습니다. 최근 128토큰만 다시 계산하는 것은 전체 입력을 모든 층에 통과시킨 상태를 그대로 복원하는 방법이 아닙니다. 층이 깊어지면서 최근 토큰의 표현에도 더 앞선 정보가 누적되기 때문입니다. DeepSeek는 이 근사를 학습에도 반영하고 품질 영향을 평가했습니다. 입력을 적게 계산하는 대신, 생략한 경계의 영향을 관리하는 설계입니다. 기술 보고서 §2.2, §3.2.2
같은 문맥을 층마다 따로 보관해야 할까?
입력을 읽는 비용을 줄여도 KV를 보관하는 비용은 남습니다. 여러 층이 긴 소스코드의 표현을 따로 저장하면, 요청 수가 늘어날수록 메모리 부담이 커집니다.
Compressed Sparse Attention 2, CSA2는 여러 층이 같은 global KV를 함께 사용하게 합니다. 여기서 한 걸음 더 나아가, ‘어느 위치를 읽을지 고른 결과’도 공유합니다.
문서 작업에 비유하면 두 가지는 다릅니다. 여러 사람이 같은 문서를 보는 것과, 앞사람이 표시한 부분을 그대로 보는 것은 같지 않습니다. CSA2도 문맥 자체를 공유하는 것과 읽을 위치를 공유하는 것을 나눕니다.
| 층의 역할 | 긴 문맥의 KV | 읽을 위치 |
|---|---|---|
| Full | 새로 만든다 | 새로 고른다 |
| Reindex | 앞선 Full 층의 것을 쓴다 | 현재 층에서 다시 고른다 |
| Reuse | 앞선 Full 층의 것을 쓴다 | 앞선 선택을 그대로 쓴다 |
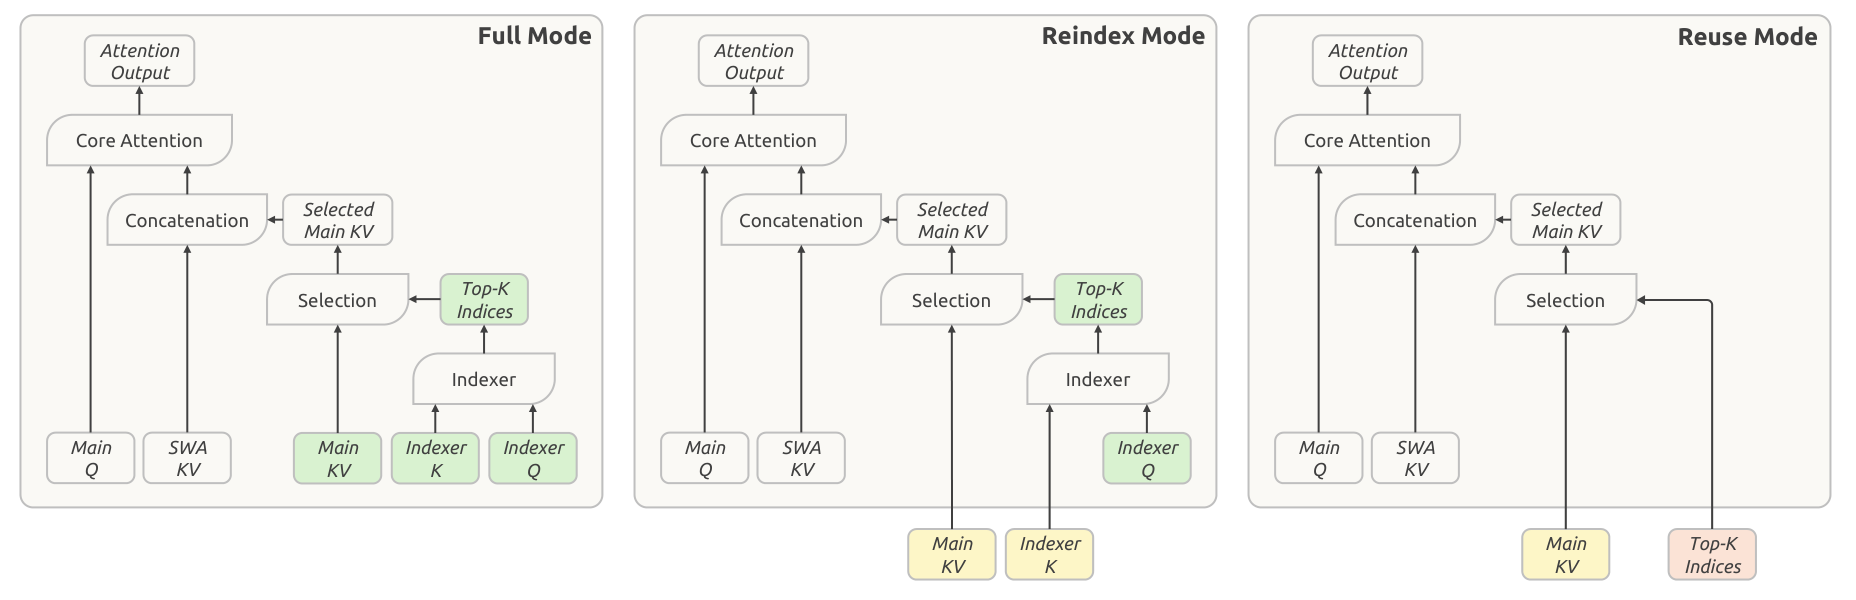
각 층의 역할은 설정에 정해져 있습니다. 요청마다 세 모드 중 하나를 고르는 것이 아닙니다. Reuse 층도 계산을 멈추지는 않습니다. 같은 위치를 읽더라도 그 층의 query로 attention을 수행하고, SWA와 MoE도 계산합니다. 다시 만들지 않는 것은 공유하기로 한 KV와 위치 목록입니다. 기술 보고서 §2.3.1
Global KV는 네 곳에서 만든다
공개 설정에서 global KV의 출처는 layer 2, 8, 14, 20입니다. 번호는 0부터 시작합니다. Encoder의 세 그룹과 decoder 전체가 사용하는 한 그룹, 총 네 곳입니다.
Encoder에서는 원래 토큰 2개를 KV entry 하나로 압축합니다. Decoder에서는 토큰별 entry를 유지합니다. 뒤쪽 20층이 같은 문맥을 읽되, 일부 층은 중요한 위치를 새로 고르고 나머지 층은 그 선택을 재사용합니다. 압축하지 않는 decoder 경로도 전체 문맥을 모두 attention에 사용하는 것은 아닙니다. 선택한 위치를 읽는 sparse attention입니다.
구현에서는 attention이 실제로 읽는 main KV와, 어느 위치가 중요한지 점수를 매기는 작은 표현인 indexer K를 사용합니다. CSA2는 이 둘을 층 사이에서 공유하고, indexer K도 main KV를 투영해 만듭니다. KV를 만드는 경로와 저장할 상태를 함께 줄인 것입니다. 기술 보고서 §2.3, §4.2.1 · 공개 설정
512개를 고르기 위해 매번 전체를 검색한다면
Sparse attention에도 숨은 비용이 있습니다. 실제로 읽을 위치를 512개로 제한하더라도, 그 512개를 찾으려고 매 층에서 백만 토큰의 점수를 매긴다면 검색 자체가 비싸집니다.
V4.1 Flash의 decoder는 처음에 넓게 찾고, 뒤에서는 후보 안에서 다시 고릅니다. 첫 Full 층인 layer 20이 전체 문맥의 점수를 계산합니다. 자신의 attention에 사용할 top-512를 고르는 동시에, 뒤의 층들이 검색할 후보군도 만듭니다.
후보군을 만들 때는 위치를 8개씩 묶습니다. 묶음 안의 최대 점수를 기준으로 최대 2,048개 묶음을 남깁니다. 뒤의 Reindex 층은 최대 2,048 × 8 = 16,384개 위치 안에서 자신의 top-512를 고르면 됩니다. 이 방식이 Hierarchical Sparse Indexer입니다.
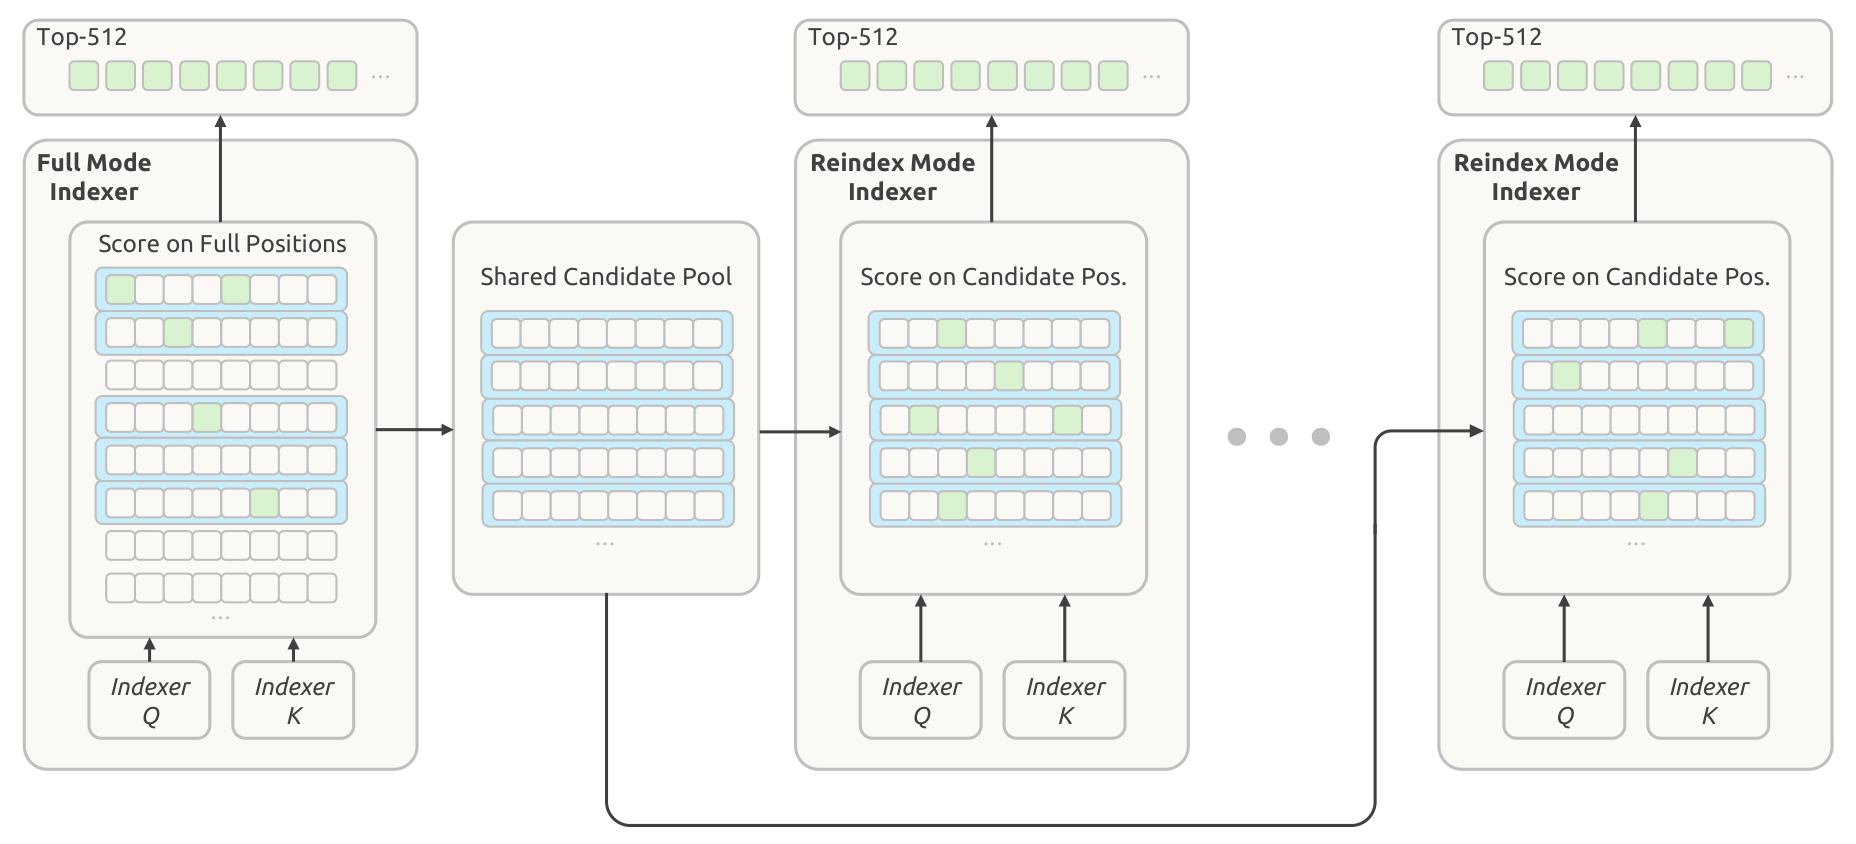
뒤의 층마다 모든 위치를 다시 검색하는 부담을 줄이는 대신, 처음 후보에서 빠진 위치를 뒤의 Reindex가 직접 선택할 수는 없습니다. 첫 검색은 여전히 전체 범위를 살피므로 모델 전체의 검색 비용이 문맥 길이와 무관해지는 것도 아닙니다.
이 구조를 보면 평가할 작업도 구체적입니다. 흔한 요약 문제뿐 아니라, 긴 로그 중 단 한 줄의 오류나 멀리 떨어진 두 파일의 관계를 찾아야 하는 경우를 확인할 필요가 있습니다. 이 모델이 그런 작업에 실패한다는 측정 결과가 아니라, 후보를 제한하는 구조에서 도출한 검증 항목입니다. 기술 보고서 §2.3.2, §6
890 bytes/token은 어떻게 나오는가
이제 KV를 얼마나 작게 저장하는지 계산할 수 있습니다. 핵심은 ‘4bit를 쓴다’ 한 가지가 아닙니다. 토큰을 압축하고, 층끼리 공유하고, 숫자 하나를 더 적은 bit로 저장하는 효과가 겹칩니다.
Main KV 한 entry는 512개 값입니다. 각각 FP4, 즉 4bit로 저장하면 512 × 0.5 = 256 bytes입니다. 양자화한 값을 해석하기 위한 scale도 필요합니다. 16개 값마다 1byte scale을 두므로 32bytes가 추가되어 총 288bytes입니다.
Indexer K는 128개 값입니다. 역시 4bit를 쓰지만 scale은 32개 값마다 하나입니다. 데이터 64bytes에 scale 4bytes를 더한 68bytes입니다. 두 표현을 합치면 entry당 356bytes가 됩니다.
Main KV       256 + 32 = 288 bytes
Indexer K      64 +  4 =  68 bytes
합계                    356 bytes

Encoder: cache 3개, 토큰 2개당 entry 1개
Decoder: cache 1개, 토큰 1개당 entry 1개

입력 토큰당 저장량
= (3 × 1/2 + 1) × 356
= 890 bytes/token
공개 설정으로 계산한 값이 보고서의 890 bytes/token과 일치합니다. Main KV는 E2M1 데이터와 E4M3 scale, indexer K는 MXFP4의 E8M0 scale을 사용합니다. FP4라는 이름이 같아도 scale의 형식과 묶음 크기는 다릅니다. 기술 보고서 §2.4.4, §6 · 설정 · 참조 코드
이 산식대로라면 128K토큰(131,072)의 global KV는 약 111.3MiB, 1M토큰(1,048,576)은 약 0.869GiB입니다. 서로 prefix를 공유하지 않는 1M 문맥 32개라면 약 27.8GiB가 됩니다.
이는 문맥 길이에 비례해 늘어나는 global cache의 논리적 저장량입니다. 실제 GPU 메모리에는 모델 가중치, SWA 상태, 실행 버퍼, 메모리 블록의 여유 공간, 병렬화에 따른 복제도 포함됩니다. 도입 비용을 계산할 때는 890이라는 숫자와 전체 메모리 요구량을 분리해야 합니다.
SWA KV는 FP4 대신 FP8로 유지합니다. 모든 상태를 같은 정밀도로 줄이지 않고, 양자화에 민감한 경로는 더 높은 정밀도를 남긴 선택입니다. Main KV는 attention 전에 값을 복원하므로, FP4 저장 형식 자체가 곧 FP4 행렬곱만 사용한다는 뜻도 아닙니다. 기술 보고서 §2.4.4
다음 도구 호출을 기다리는 동안 무엇을 남길까?
모델이 테스트 실행을 요청하고 결과를 기다리는 동안에는 다음 요청을 위한 문맥을 보관해 둘 수 있습니다. 결과가 돌아오면 같은 코드를 처음부터 다시 읽지 않는 편이 유리하기 때문입니다. 이렇게 대기 중인 작업이 많아지면 오래 보관하는 캐시의 크기가 중요해집니다.
V4.1 Flash는 오래 보관할 global KV와 필요할 때 다시 만들 SWA를 구분합니다. 보고서의 배포 구성에서는 global KV를 SSD나 host memory의 장기 캐시에 보관합니다. Encoder SWA는 활성 세션을 위한 수명 짧은 host-memory pool에 둡니다. Decoder SWA는 prefix cache에 넣지 않고 매 prefill에서 bounded replay로 준비합니다.
오랜 뒤에 요청이 돌아와 global KV만 남아 있다면 어떻게 될까요? 최근 128토큰을 재처리해 encoder SWA를 만들고, 이미 저장된 global KV는 그대로 사용합니다. 그다음 새로 붙은 테스트 로그를 처리합니다. 모든 상태를 오래 저장하는 대신, 다시 만드는 비용을 작은 범위로 제한한 것입니다.
이 정책이 보고서의 persistent KV 약 1/8이라는 수치와 연결됩니다. 기존 V4 배포에서는 장기 캐시의 거의 절반을 SWA가 차지했습니다. 이를 보관 대상에서 빼고 global KV 자체도 약 1/4로 줄였다는 설명입니다. 같은 workload를 비교한 DeepSeek의 배포 수치이지, 모든 서비스의 전체 메모리가 자동으로 1/8이 된다는 의미는 아닙니다. 기술 보고서 §3.2.1
최근 구간만 재처리하기 때문에 캐시가 남아 있던 경우와 일부가 사라진 경우의 계산 상태가 완전히 같다고 보장되지는 않습니다. 실제 도입 시 ‘첫 요청’, ‘곧바로 이어지는 요청’, ‘한참 뒤에 돌아온 요청’을 나눠 품질과 첫 응답 시간을 비교할 이유가 있습니다. 이 배포 정책은 모델 가중치와 별개로 serving engine이 구현해야 하는 부분입니다. 기술 보고서 §3.2.2, §6
나머지 구조도 같은 방향을 따른다
CED와 CSA2가 큰 계산 경로를 바꾼다면, 나머지 구성은 GPU 안에서 데이터를 이동하고 출력을 만드는 비용을 줄입니다. 아키텍처 전체를 이해하려면 다음 세 가지도 함께 볼 만합니다.
Single-Pass mHC: 같은 데이터를 덜 읽고 쓴다
V4.1 Flash는 층 사이에 4개 residual stream을 유지하고 이를 섞는 mHC 구조를 사용합니다. 문제는 stream을 섞을 비율을 계산한 뒤, 실제로 섞기 위해 데이터를 다시 읽는 과정입니다.
Single-Pass mHC는 이번 block의 입력을 섞는 비율을 이전 block에서 미리 준비하도록 바꿉니다. 이 의존성을 바꾸면 residual update, 입력 혼합, 다음 비율의 계산 등을 하나의 kernel로 합치기 쉬워집니다. 보고서의 mHC 경로 activation traffic은 (4n + 4)d에서 (2n + 2)d로 줄어듭니다. 여기서 n은 stream 수, d는 표현의 차원입니다. Stream이 4개이면 20d에서 10d입니다.
줄어드는 것은 이 경로의 메모리 읽기·쓰기 양입니다. 전체 모델이 두 배 빨라진다는 수치가 아니라, 작은 구조 변경으로 GPU가 같은 데이터를 여러 번 옮기지 않게 한 사례입니다. 기술 보고서 §2.4.1
DSpark: 다음 토큰을 미리 제안하고 검증한다
Speculative decoding은 가벼운 drafter가 여러 출력 토큰을 제안하고 본 모델이 검증하는 방식입니다. 제안이 잘 맞으면 토큰을 하나씩 확정할 때보다 효율적일 수 있습니다.
V4.1 Flash의 DSpark는 3개 Transformer block으로 다섯 draft 위치를 병렬로 준비합니다. Markov head가 후보 토큰 사이의 관계를 보완하고, confidence head는 각 위치가 승인될 가능성을 예측합니다. Scheduler는 이 값과 엔진의 처리량을 함께 보고 얼마나 긴 후보를 검증할지 정합니다.
매번 다섯 토큰을 확정하는 구조는 아닙니다. 후보가 잘 맞는지, 여러 요청을 함께 처리할 때 draft 비용이 얼마나 드는지에 따라 이득이 달라집니다. Engram의 n-gram 조회와도 별개로 출력 생성 단계를 빠르게 만드는 장치입니다. 기술 보고서 §2.4.3
이미지는 먼저 토큰 수를 줄여 전달한다
이미지는 32층 DeepSeek-ViT를 거칩니다. 여기서 얻은 feature를 3×3 단위로 묶어 channel 방향으로 재배열하고, MLP projector를 통해 언어 backbone으로 전달합니다. 이 pixel-unshuffle 과정에서 visual token 수는 9분의 1이 됩니다.
이미지 자체를 읽는 vision encoder의 비용까지 9분의 1이 되는 것은 아닙니다. 코드뿐 아니라 화면 캡처도 입력으로 사용하는 작업에서는 이미지 인코딩 시간과 언어 모델의 prefill 시간을 나눠 살펴봐야 합니다. 기술 보고서 §2.1.1
공개 코드를 읽어 보니 남는 차이
아키텍처를 이해하는 것과 실제로 그 성능을 내는 것은 다른 작업입니다. 공개 저장소도 자신을 production serving engine이 아닌 읽기 쉬운 참조 구현으로 설명합니다. Minimal inference README
확인한 revision의 Transformer.forward는 입력을 40개 층에 순서대로 통과시킵니다. 논문의 CED prefill 생략과 bounded replay를 그대로 수행하는 배포 경로는 아닙니다. Indexer.forward도 전체 key의 점수를 계산한 뒤 후보 밖을 mask합니다. 어떤 위치를 선택할지 표현하지만, 뒤의 indexer가 후보만 계산하는 최적화까지 재현하지는 않습니다.
DSpark의 forward 경로 역시 존재하지만 기본 generation은 일반적인 autoregressive sampling입니다. 코드에 module이 있다는 사실과 배포 엔진에서 그 최적화가 실제로 켜져 있다는 사실을 구분해야 합니다. Transformer.forward, Indexer.forward
직접 서빙한다면 가중치를 로드할 수 있는지에서 확인을 끝내면 안 됩니다. 사용하는 엔진이 CED 실행 경로, 공유·양자화 KV, 계층형 indexer, Engram 전송, speculative decoding 중 어디까지 지원하는지 확인해야 보고서의 수치와 비교할 수 있습니다.
품질 향상도 마찬가지입니다. V4.1 Flash는 아키텍처만 바꾼 모델이 아니라 학습 데이터와 과정도 바뀐 모델입니다. 보고서는 45T토큰 학습과 긴 문맥 학습의 확장 과정을 설명합니다. 전체 benchmark 점수가 올랐다는 이유만으로 Engram 하나가 그 차이를 만들었다고 결론 내릴 수는 없습니다. 기술 보고서 §4.2.2, §5
실제 서비스에서 먼저 확인할 것
처음의 버그 수정 작업으로 돌아가 보겠습니다. V4.1 Flash는 긴 코드를 읽을 때 decoder 전체를 계산하지 않고, 보관할 KV를 공유하고 압축하며, 다음 요청에는 남겨 둔 문맥을 재사용합니다. 로그가 길어져도 뒤의 indexer는 제한된 후보 안에서 필요한 부분을 찾습니다. 파일 읽기와 수정, 테스트가 반복될 때 비용이 쌓이는 지점을 각각 줄이는 설계입니다.
직접 평가한다면 큰 benchmark 하나보다 다음 세 상황부터 비교하겠습니다. 아래는 아직 수행하지 않은 검증 제안입니다.
첫째, 입력 길이에 따라 어디서 기다리는지 봅니다. 같은 수정 작업에 짧은 코드와 긴 저장소 문맥을 넣고, 첫 토큰까지의 시간과 전체 완료 시간을 나눠 측정합니다. 입력 처리가 병목인지, 긴 출력을 만드는 단계가 병목인지 구별할 수 있습니다.
둘째, 도구 호출 사이의 대기 시간을 바꿉니다. 테스트 결과를 바로 돌려주는 경우와 한참 뒤에 돌려주는 경우를 비교합니다. Global KV와 SWA의 보관 수명이 다르기 때문에 지연뿐 아니라 작업 성공률도 함께 봐야 합니다.
셋째, 드문 단서를 긴 문맥에 배치합니다. 원인이 로그 한 줄에만 있거나 서로 먼 파일에 나뉘어 있는 작업을 준비합니다. 답변의 유창함보다 필요한 근거를 찾아 실제로 수정에 성공했는지를 확인합니다. Sampling의 변동을 고려해 여러 번 실행하는 것이 좋습니다.
Engram과 Qwen의 n-gram embedding을 함께 보면, 학습된 패턴의 저장과 현재 문맥의 처리를 서로 다른 경로에 맡긴다는 방향이 보입니다. DeepSeek V4.1은 현재 문맥도 모든 층에서 따로 만들고 끝까지 보관하지 않습니다. 공유해도 되는 문맥은 공유하고, 작은 범위로 다시 만들 수 있는 상태는 재계산하며, 짧은 패턴의 표현은 학습된 표에서 가져옵니다.
그 이득이 서비스에 이어지려면 최적화된 serving engine과 작업에 맞는 품질 검증이 필요합니다. 긴 입력과 도구 호출이 반복되는 기능을 만든다면 V4.1 Flash의 구조와 실제 실행 환경을 함께 살펴볼 만합니다.
KV cache의 기본 원리와 반복 문맥 재사용이 궁금하다면 KV Cache와 LMCache를 다룬 글을 함께 참고할 수 있습니다.
참고 자료
- 공식 모델 카드 — 전체 구성과 파라미터 규모.
- DeepSeek-V4.1 Technical Report — 아키텍처, 추론 시스템, 학습 설정과 한계.
- config.json — 층별 역할, cache 출처, precision과 Engram 설정.
- inference/model.py — Attention, Indexer, Engram, Transformer 참조 구현.
- inference/engram.py — token 정규화와 n-gram hash lookup.
- Minimal inference README — 참조 코드가 구현하는 범위.
- Engram 공식 저장소 — n-gram conditional memory의 원래 설계와 원본 그림.
- Qwen3.8-Flash-Next 모델 카드 — n-gram 규모와 GDN·QSA 혼합 구성.
- Qwen3.8-Next 기술 보고서 — n-gram ablation과 hybrid attention 설계.
- Gated Delta Networks 논문 — Mamba2의 gating과 delta rule의 관계.