

GPU 시장의 혼란, 그리고 DeepSeek의 새 버전
RTX 5090, 단종설보다 더 들여다볼 문제가 있습니다
‘RTX 5090이 단종된다’는 이야기가 퍼졌습니다. 미국 판매점 Micro Center에서 여러 5090 제품이 단순 품절이 아닌 ‘Not Carried’, 즉 해당 매장에서 취급하지 않는 상태로 표시되면서 불안이 커졌습니다. 모델을 직접 돌릴 PC를 준비하던 사람에게도 남의 일이 아닙니다.
NVIDIA는 10월 16일 단종설을 부인했지만 공급 제약은 인정했습니다. 국내에서도 여러 모델의 판매 등록가가 이미 1,000만 원을 넘었습니다. 로컬 AI용 장비를 준비하는 사람에게는 단종 여부만큼이나, 지금 얼마에 구할 수 있느냐가 중요한 문제입니다.
DeepSeek V4.1-Flash-1017, ‘저렴한 대안’에서 한 걸음 더
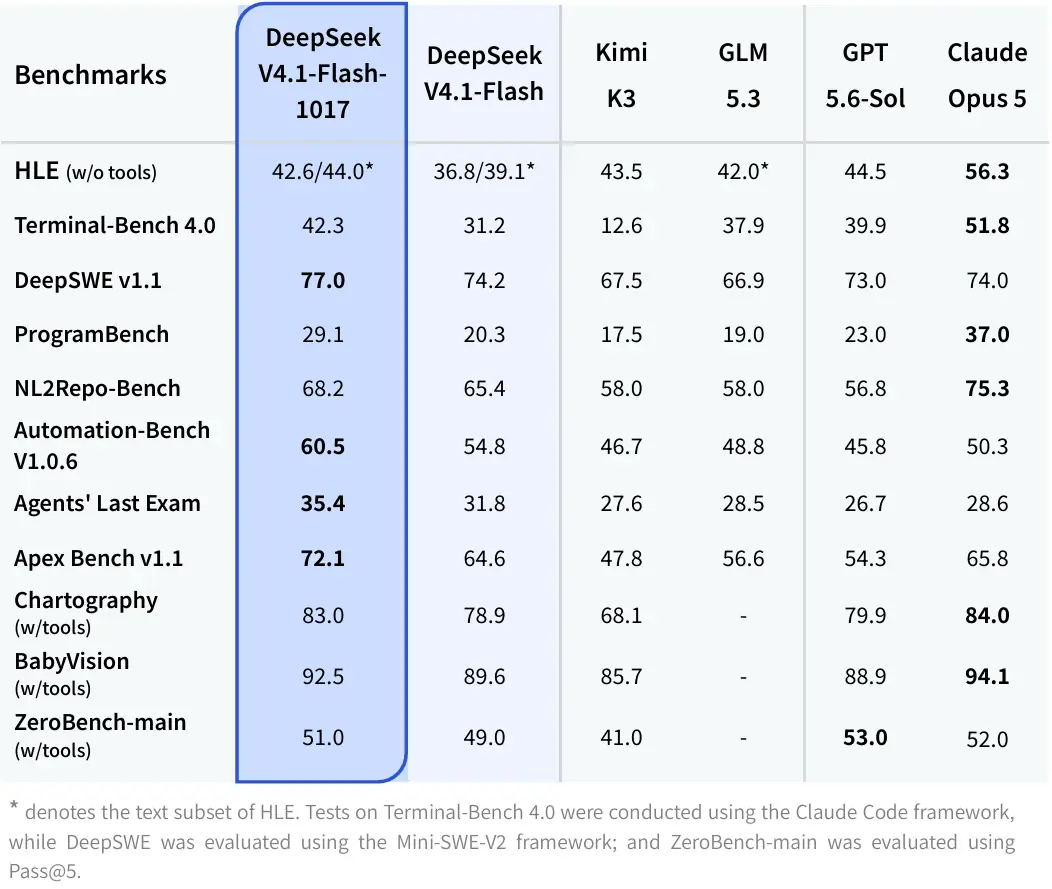
이번에 주목할 모델은 9월의 V4.1 Flash가 아니라, 10월 17일 새로 공개된 V4.1-Flash-1017입니다. DeepSeek의 비교표에서 터미널 작업과 프로그램 작성 점수가 크게 올랐고, 일부 개발·자동화 평가에서는 비교 대상으로 실린 유료 모델들을 앞섰습니다. API 요금은 그대로입니다.
단순히 문제를 더 잘 푼다는 발표만 있는 것도 아닙니다. 자금성 3D 모델, 웹 레이싱 게임, Godot 엔진으로 재현한 Portal 2 등 프로젝트 제작 데모를 함께 공개했습니다. ‘코드 한 조각을 답하는 능력’에서 ‘여러 부분을 엮어 결과물을 만드는 능력’으로 관심이 옮겨갈 만한 업데이트입니다.
RTX Spark, 최대 128GB 메모리를 갖춘 AI 노트북
NVIDIA의 RTX Spark 노트북이 10월 16일 출시됐습니다. ASUS·Dell·HP·Lenovo·Microsoft·MSI가 참여하며 시작 가격은 2,599달러입니다. 책상 위의 DGX Spark와는 다른 제품군으로, Windows 노트북에 Arm 기반 CPU와 Blackwell GPU를 넣었습니다. 지역별 가격과 구성은 다릅니다.
핵심은 CPU와 GPU가 함께 쓰는 최대 128GB 통합 메모리입니다. 별도 GPU 메모리에 다 넣기 어려웠던 모델이나 대용량 3D 장면을 노트북에서 다룰 여지가 생깁니다. 다만 운영체제도 이 메모리를 함께 쓰며, 5090의 32GB 그래픽 메모리와 용량만 비교해 어느 쪽이 더 빠르다고 판단할 수는 없습니다.
새로운 점은 큰 메모리만이 아닙니다. NVIDIA와 Microsoft는 Windows on Arm용 PyTorch-CUDA 등 개발 환경도 함께 준비했습니다. 큰 통합 메모리와 CUDA를 노트북에서 함께 쓸 수 있게 된 겁니다. 이미 통합 메모리로 로컬 AI를 실행하던 MacBook Pro와 비교하게 되는 이유도 여기에 있습니다.
RTX Spark와 MacBook Pro, 같은 128GB라도 다릅니다
‘이제 맥북 대신 Spark를 사면 될까?’라는 질문이 자연스럽습니다. MacBook Pro도 M5 Max의 40코어 GPU 구성에서는 최대 128GB 통합 메모리를 지원합니다. 두 제품 모두 큰 모델을 담을 수 있는 노트북이지만, 모델을 실행하는 도구와 잘 맞는 작업은 다릅니다. 여기서는 RTX Spark N1X의 상위 구성과 MacBook Pro의 M5 Max 구성을 비교합니다.
메모리 · 양쪽 모두 최대 128GB
CPU와 GPU가 함께 쓰는 통합 메모리입니다. Spark의 20코어 CPU 구성은 최대 128GB, 18코어 구성은 최대 64GB입니다. MacBook Pro의 128GB는 M5 Max 40코어 GPU 구성에서 선택합니다. 어느 쪽도 전부를 모델 저장에 쓸 수 있는 것은 아닙니다.
CPU·GPU · 코어 수를 그대로 비교할 수는 없습니다
상위 Spark N1X는 20코어 Grace CPU와 6,144코어 Blackwell GPU, 상위 M5 Max는 18코어 CPU와 40코어 GPU입니다. NVIDIA의 CUDA 코어와 Apple의 GPU 코어는 구조와 세는 단위가 달라, 숫자를 나눠 성능 차이를 계산하면 안 됩니다.
AI 실행 · CUDA와 MLX라는 두 가지 환경
Spark는 Windows on Arm에서 CUDA·TensorRT를 활용합니다. Mac은 Apple Silicon에 맞춘 MLX 등으로 로컬 모델을 실행할 수 있습니다. 기존 CUDA 작업을 이어갈지, MLX 지원 모델을 주로 쓸지가 선택 기준입니다. Spark에서도 Windows on Arm용 라이브러리 호환은 별도로 확인해야 합니다.
‘모델이 들어간다’와 ‘빠르게 돌아간다’는 다른 이야기
메모리 용량은 얼마나 큰 모델을 담을 수 있는지, 대역폭은 그 데이터를 얼마나 빨리 읽을 수 있는지에 관계됩니다. M5 Max 상위 구성의 공식 대역폭은 614GB/s입니다. 그렇다고 이 숫자 하나로 승자를 정할 수는 없습니다. 모델의 저장 형식과 실행 도구에 따라 속도가 달라지고, 긴 질문을 처음 읽는 작업과 답변을 한 토큰씩 만드는 작업의 특성도 다릅니다.
Spark의 ‘최대 1페타플롭’ 역시 FP4라는 저정밀 연산 조건의 수치이지, 맥북보다 몇 배 빠르다는 뜻은 아닙니다. 비교할 때는 같은 모델·양자화 수준·문맥 길이를 맞추고, 첫 답변까지 걸린 시간과 이후 생성 속도를 따로 보는 편이 낫습니다. 이 레터에서는 두 기기를 직접 측정하지 않았으므로 속도 순위는 매기지 않습니다.
가격과 휴대성은 실제 구매할 구성으로 비교하세요
Spark의 시작 가격 2,599달러는 128GB 모델의 가격이 아닙니다. MacBook Pro도 128GB를 고르려면 상위 M5 Max 구성이 필요합니다. 같은 메모리와 SSD 용량으로 견적을 맞춰야 실제로 어느 쪽이 저렴한지 알 수 있습니다. 미국 발표 가격을 국내 구매 비용으로 그대로 바꾸는 것도 피해야 합니다.
휴대성은 Spark 칩 전체가 아니라 완제품별로 봐야 합니다. 예를 들어 Surface Laptop Ultra는 15형 화면에 4.5파운드 미만(약 2.04kg 미만)으로 안내됩니다. 배터리도 제조사의 영상 재생·웹 사용 시간과 AI를 계속 실행하는 시간은 다릅니다. 들고 다니며 쓸 장비라면 충전기를 뺀 상태의 속도, 발열과 소음까지 확인할 필요가 있습니다.
저희가 보는 변화는 ‘맥북을 살 이유가 없어졌다’가 아닙니다. 큰 메모리로 로컬 AI를 쓰려는 사람에게 CUDA 기반 Windows 노트북이라는 선택지가 더해졌다는 점입니다. 이미 Mac에서 필요한 모델을 잘 돌리고 있다면 사양표만 보고 바꾸기보다, 지금 막히는 작업을 Spark가 해결하는지부터 확인하는 편이 낫겠습니다.
‘단종이 아니다’만으로는 설명되지 않는 5090 사태
이번 혼란에는 서로 다른 세 가지 이야기가 섞였습니다. 제조사가 생산을 끝냈다는 소문, 판매점이 상품을 취급하지 않는다는 표시, 그리고 실제로 물량이 부족하다는 문제입니다. 시간순으로 보면 무엇이 확인됐는지 더 선명해집니다.
10월 10일 · ‘전문 GPU로 물량을 돌린다’는 소문
GB202 칩의 향후 공급이 RTX PRO 전용으로 바뀐다는 유출 계정의 주장이 보도됐습니다. NVIDIA의 생산 종료 발표가 아니었고, 실제 물량 배분도 공개되지 않았습니다.
10월 14~15일 · 판매 목록의 변화가 불안을 키움
Micro Center의 여러 5090 제품에 ‘Not Carried’ 표시가 나타났다는 이용자 제보와 보도가 이어졌습니다. Austin 매장 목록에서도 이 표기를 확인할 수 있습니다. 다만 특정 매장의 취급 상태가 전 세계 생산 종료를 뜻하지는 않습니다.
10월 16일 · NVIDIA는 단종 부인, 공급 제약은 인정
타이베이 행사에서 Jeff Fisher 수석부사장은 5090을 계속 공급하겠다고 밝혔습니다. 동시에 공급망 제약을 언급했으며, 이 인터뷰에 재고 정상화 날짜나 지역별 공급량은 제시되지 않았습니다.
참고 자료
국내에서도 그래픽카드 한 장에 1,000만 원
10월 18일 다나와에 표시된 모델별 최저 등록가는 MSI 슈프림 SOC 약 1,035만 원, ZOTAC SOLID OC 약 1,044만 원, ASUS ROG Astral OC(대원씨티에스) 약 1,053만 원입니다. MANLI Gallardo OC처럼 979만 원인 제품도 있어 모든 5090이 1,000만 원을 넘은 것은 아니지만, 여러 모델에서 이미 그 선을 넘어섰습니다.
이는 판매자가 등록한 가격이며, 실제 거래 완료 가격이나 즉시 출고를 보장하는 값은 아닙니다. 그래도 장비 예산을 잡는 입장에서는 무시하기 어려운 숫자입니다. 그래픽카드 외에 나머지 PC 구성까지 필요한 만큼, 로컬 AI를 시작하는 비용과 도입 일정에 직접 영향을 줍니다.
왜 하필 ‘AI용 제품으로 돌린다’는 말이 나왔을까?
여기에는 실제 제품 구조가 배경으로 있습니다. NVIDIA 문서에 따르면 RTX 5090과 전문가용 RTX PRO 6000 Blackwell은 모두 GB202 계열 칩을 씁니다. 5090은 32GB GDDR7 메모리를, RTX PRO 6000은 96GB를 갖췄습니다. 같은 계열 칩이 게이밍 카드와 전문 작업용 제품에 쓰이니, 생산 배분을 둘러싼 추측이 나올 여지가 있습니다.
하지만 ‘같은 계열 칩을 쓴다’와 ‘5090 생산을 끊고 전부 RTX PRO로 돌렸다’는 전혀 다른 주장입니다. 전자는 공식 사양으로 확인되지만 후자는 확인되지 않았습니다. B200처럼 다른 칩을 쓰는 데이터센터 GPU도 있으므로, 모든 AI 서버용 GPU와 5090을 같은 생산 제품처럼 묶어서도 안 됩니다.
게이밍 카드 한 장의 품귀가 로컬 AI에도 중요한 이유
5090은 게임뿐 아니라 로컬 LLM, 이미지·영상 생성에도 활용되는 제품입니다. 이미 CUDA 환경으로 작업을 만들었다면, 메모리 용량이 비슷한 다른 장비를 구해도 실행 도구와 속도까지 그대로 옮겨지는 것은 아닙니다. 그래서 수급 문제는 부품 가격을 넘어, 준비해둔 작업을 언제 시작할 수 있느냐의 문제가 됩니다.
지금까지 확인되는 결론은 ‘단종 확정’도, ‘곧 정상화’도 아닙니다. 공급은 계속되지만 판매점에서 원하는 제품을 구하기 어려운 상황입니다. 국내 구매를 검토한다면 미국 매장 소식을 국내 재고와 동일시하지 말고, 실제 견적·입고일·보증을 확인해야 합니다. 단종 소문만으로 웃돈을 지불하거나, 발표 가격만으로 구축 예산을 잡기에는 정보가 부족합니다.
이번에는 아키텍처보다, 좋아진 결과물에 주목합니다
9월 V4.1 Flash의 관심사가 새로운 구조와 메모리 효율이었다면, 1017에서 눈에 띄는 것은 개발·도구 사용 성능의 상승입니다. DeepSeek는 자기 피드백을 활용한 강화학습으로 프로젝트를 처음부터 완성하는 능력을 개선했다고 설명합니다. 만든 결과를 평가한 신호를 학습에 활용한다는 방향이며, 구체적인 개선분을 어느 기법이 얼마나 만들었는지까지 공개한 것은 아닙니다.
터미널 작업 · 31.2 → 42.3
Terminal-Bench 4.0에서 11.1점 올랐습니다. 명령어·파일·도구를 다루는 작업의 변화입니다. 같은 공식 표의 GPT-5.6 Sol은 39.9, Opus 5는 51.8입니다.
소프트웨어 수정 · 74.2 → 77.0
DeepSWE v1.1에서 이전 버전보다 2.8점 높아졌습니다. 공식 표에서는 Opus 5의 74.0, GPT-5.6 Sol의 73.0보다 높은 결과입니다.
프로그램 작성 · 20.3 → 29.1
ProgramBench에서도 8.8점 상승했습니다. GPT-5.6 Sol의 23.0보다 높고 Opus 5의 37.0보다는 낮습니다. 모든 작업에서 일괄적으로 앞선다는 그림은 아닙니다.
위 숫자는 DeepSeek가 공개한 비교표입니다. Terminal-Bench에는 Claude Code, DeepSWE에는 Mini-SWE-V2라는 실행 도구를 사용했습니다. 비교 대상도 정확히 Opus 5와 GPT-5.6 Sol이지, Opus 5.5나 GPT-6.1 Sol까지 모두 이겼다는 결과는 아닙니다.
그 점을 감안해도 변화는 작지 않습니다. 저렴해서 가벼운 작업만 맡기던 모델을, 이제 더 복잡한 개발 작업의 후보로 다시 평가할 이유가 생겼습니다. 특히 여러 번 실행하고 고치는 작업에서는 한 번의 답변 품질뿐 아니라 끝까지 해결하는 비율이 중요합니다.
성능만큼 중요한 것은, 그 결과를 내는 데 든 비용입니다
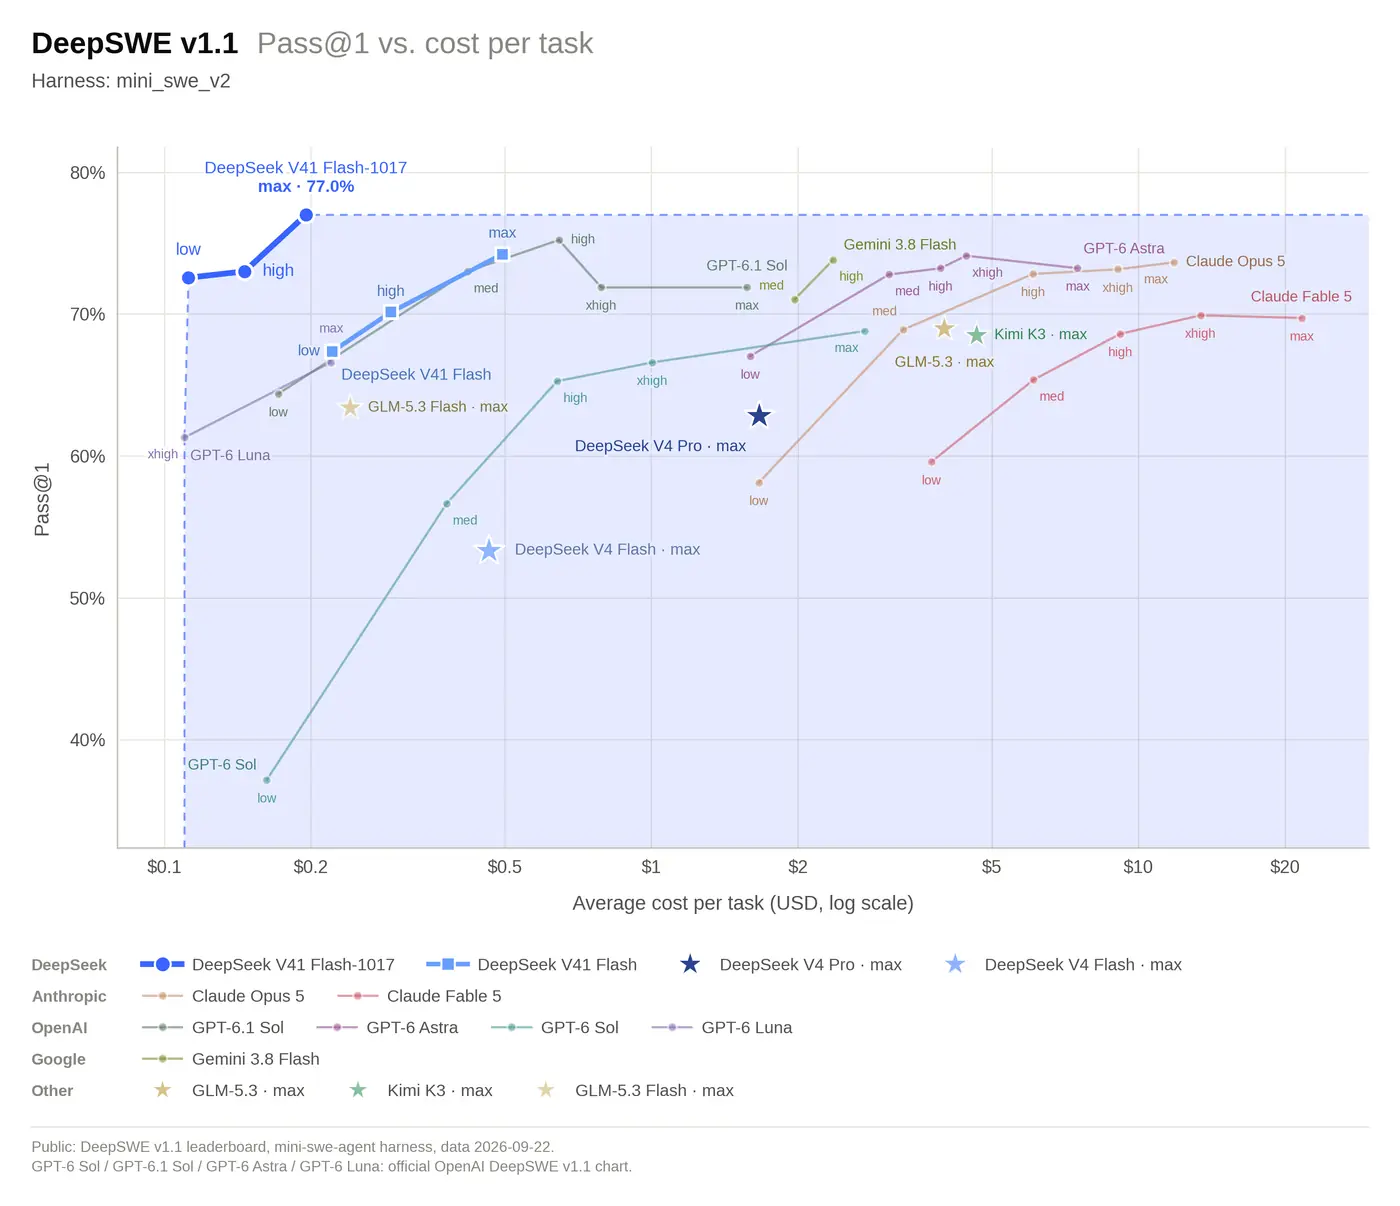
위 그래프는 위로 갈수록 성공률이 높고, 왼쪽으로 갈수록 작업당 비용이 낮습니다. 1017의 파란 점은 이전 Flash보다 왼쪽 위에 놓여 있습니다. 같은 평가에서 더 적은 비용으로 더 높은 성공률을 냈다는 것이 이번 발표의 핵심입니다.
가로축은 로그 눈금이며, 비교 자료의 일부는 9월 22일 공개 리더보드 기준입니다. 모든 경쟁 모델을 같은 날 같은 설정으로 재시험한 결과는 아니고, 실제 절감액도 맡기는 작업과 재시도 횟수에 따라 달라집니다.
직접 API의 100만 토큰당 요금은 비혼잡 시간 입력 0.15달러·출력 0.60달러, 혼잡 시간 0.30달러·1.20달러입니다. 입력은 캐시 미적중 기준입니다. 단가는 그대로인데 작업 시간과 출력 길이를 줄였다는 설명이 더해졌으니, 기존에 비싸서 시도하지 못했던 반복 작업에도 비교해볼 만합니다.
게임과 3D 데모가 보여주는 것
공식 데모에는 자금성의 3D 공간, 웹 레이싱 게임, Godot 기반 Portal 2 재현이 있습니다. 게임 하나를 만들려면 화면만 그리는 것이 아니라 입력 처리, 움직임, 장면 구성처럼 여러 부분을 연결해야 합니다. 이런 결과물은 벤치마크 이름보다 이번 변화의 방향을 쉽게 보여줍니다. 다만 데모만으로 제작 시간이나 사람의 수정 횟수까지 알 수는 없습니다.
우리 업무로 옮기면, 가상의 운영 데이터를 넣은 대시보드나 제품 설명용 인터랙티브 페이지를 만들어보는 식으로 시험할 수 있겠습니다. 웹·앱에는 이미 새 모델이 반영됐고 API 이름은 deepseek-flash입니다. 100만 토큰 문맥, 이미지 입력과 도구 호출도 지원합니다. 공개 가중치가 있다는 것과 노트북 한 대에서 쉽게 실행된다는 것은 별개이므로, 먼저 웹이나 API에서 결과물의 변화를 보는 편이 간단합니다.
‘어떤 GPU를 살까’와 ‘어떤 모델을 쓸까’는 다른 질문입니다
5090의 공급이 불안정하다고 AI를 쓰는 비용이 모두 오르는 것은 아닙니다. 이번 DeepSeek처럼 같은 API 요금에서 더 나은 결과를 내는 모델도 나옵니다. 반대로 API가 저렴해졌다고 로컬 장비의 필요가 사라지는 것도 아닙니다. 외부로 보낼 수 없는 데이터를 다루거나 인터넷 없이 실행해야 한다면, 성능 외의 요구가 선택을 바꿉니다.
그래서 두 결정을 한꺼번에 내리지 않으려 합니다. 먼저 새 모델이 필요한 결과를 만드는지 확인하고, 그다음 데이터 처리 위치와 반복 사용량을 기준으로 API와 로컬 실행을 비교하는 순서입니다. Spark의 128GB도, 5090의 성능도, DeepSeek의 낮은 단가도 그때 비로소 우리 일에 필요한 숫자가 됩니다.
예전에 만들다 멈춘 작은 화면을 다시 맡겨보세요
1017의 프로젝트 제작 능력을 확인하는 작은 실험입니다. 가상의 주문 데이터 20건으로 ‘기간별 매출과 상태별 주문 수를 보는 한 페이지’를 요청해보세요. 기존에 쓰던 모델에도 같은 데이터와 요청을 주고 비교합니다. 실제 고객 정보는 넣지 않습니다.
보기 전에, 작동 조건부터 세 개
합계가 원본 데이터와 일치할 것, 날짜 필터를 바꾸면 수치도 바뀔 것, 결과가 없는 기간에는 빈 상태를 보여줄 것. 보기 좋은 화면과 쓸 수 있는 화면을 구분합니다.
첫 화면이 아니라 수정 과정까지 비교
오류가 나면 같은 수준의 피드백을 주고, 몇 번 고쳐야 조건을 통과하는지 기록합니다. 모델명·실행 도구·전체 소요 시간도 함께 남깁니다.
API라면 완성까지의 비용을 합산
첫 답변 한 번의 요금이 아니라 재시도와 수정 요청까지 더합니다. 이번 업데이트가 내 작업에서도 ‘더 잘, 더 적은 비용으로’ 끝내는지 확인하는 방법입니다.
DeepSeek의 구조와 로컬 실행을 더 알아보고 싶다면
DeepSeek V4.1 Flash 아키텍처 분석
Engram의 n-gram 조회, 입력 계산을 나누는 CED, 문맥 저장 비용을 줄이는 CSA2를 풀었습니다. 1017 업데이트의 기반이 된, 9월 공개 모델의 구조를 이해하는 글입니다.
아키텍처 읽기 →
Mac mini에서 30B급 로컬 LLM 돌리기
M4 Pro 24GB에서 MLX로 여러 모델을 비교했습니다. 실행 속도뿐 아니라 메모리 부족과 운영 설정까지, 로컬 모델을 고를 때 만나는 문제를 담았습니다.
실행 기록 읽기 →